
GLM-5.1 是 Zai 的新一代旗舰基础模型,专为智能体工程设计,能在复杂的系统工程和长程智能体任务中提供可靠的生产力。在编码和智能体能力方面,GLM-5 在开源领域达到了最先进 (SOTA) 的性能,其在实际编程场景中的可用性接近 Claude Opus 4.5。
返回模型列表 100%$0.8781-1.1709/ 百万 token$3.5126-4.098/ 百万 token读取:0.1903-0.2927/ 百万 token写入:-/ 百万 token200K7.92s2.41tps
 -$0.8781-1.1709/ 百万 token$3.5126-4.098/ 百万 token读取:0.1903-0.2927/ 百万 token写入:-/ 百万 token200K--
 -$0.8781-1.1709/ 百万 token$3.5126-4.098/ 百万 token读取:0.1903-0.2927/ 百万 token写入:-/ 百万 token200K4.5s12.8tps
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
Streamlake
streamlake
SiliconFlow
siliconflow
BigModel
bigmodel
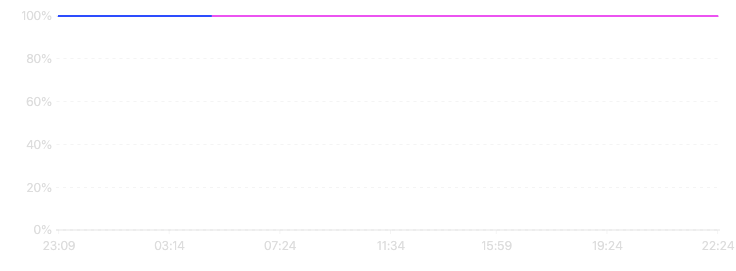
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 19:59
Streamlake100.00%
BigModel100.00%
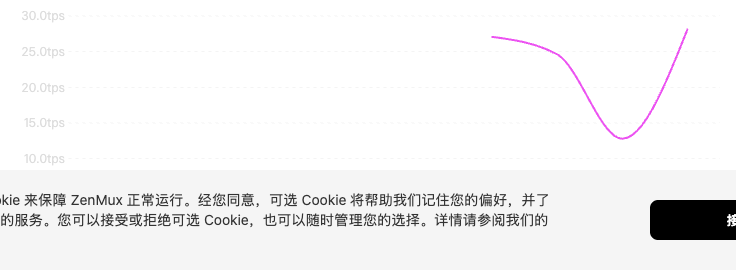
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
Oct 26, 19:00
Streamlake-
BigModel12.8 tps
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
Oct 26, 19:00
Streamlake-
BigModel4.50s
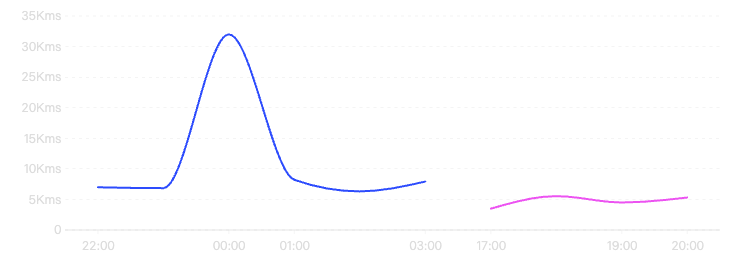
活动
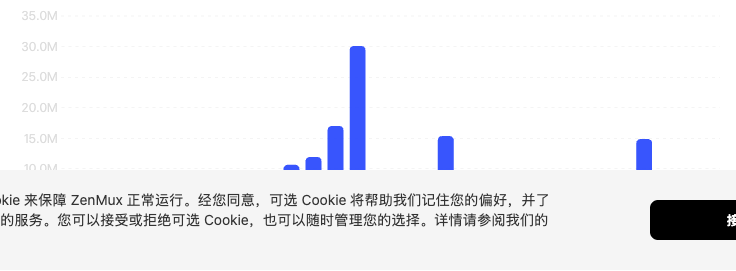
该模型随时间变化的 token 用量和请求流量。
Token 消耗
Oct 25
Streamlake7.7M
SiliconFlow-
BigModel517
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
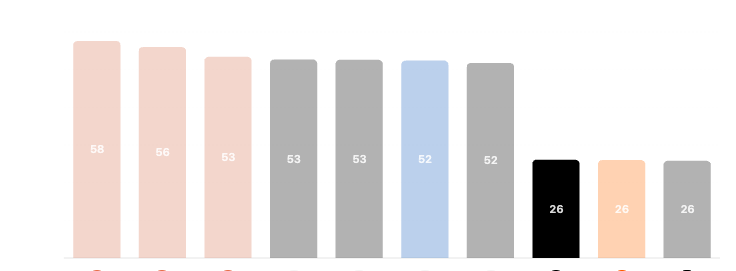
 Artificial Analysis


Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行

相关模型
更多模型来自 Z.ai