
Claude Opus 4.5 是 Anthropic 最新的前沿推理模型,专为复杂的软件工程、代理工作流和长周期计算机使用而设计。它有强大的多模态能力,在实际编码和推理基准测试中表现出色,并提高了抵御 prompt injection 攻击的鲁棒性。该模型用来跨各种努力程度高效运行,允许开发者根据特定任务需求平衡速度、深度和 token 使用量——你可以通过 OpenRouter 的 Verbosity 参数微调 token 效率,该参数提供低、中、高设置。另外,Opus 4.5 支持高级工具使用、扩展的上下文管理和协调的多代理设置,使其成为自主研究、调试、多步规划以及电子表格或浏览器操作的理想选择。与前几代 Opus 相比,它在结构化推理、执行可靠性和对齐方面带来了实质性的改进,同时减少了 token 开销,并在长时间运行的任务中提供了更一致的性能。
返回模型列表 -$5/ 百万 token$25/ 百万 token读取:0.5/ 百万 token写入:6.25-10/ 百万 token200K--
 67.0%$5/ 百万 token$25/ 百万 token读取:0.5/ 百万 token写入:6.25-10/ 百万 token200K1.13s52.7tps
 -$5/ 百万 token$25/ 百万 token读取:0.5/ 百万 token写入:6.25-10/ 百万 token200K--
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
Anthropic
anthropic
Google Vertex
google-vertex
Amazon Bedrock
amazon-bedrock
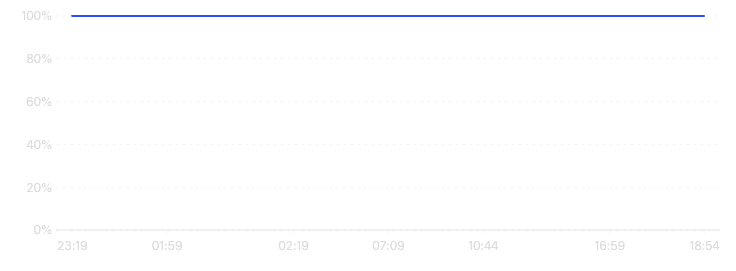
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 18:54
Google Vertex100.00%
Amazon Bedrock-
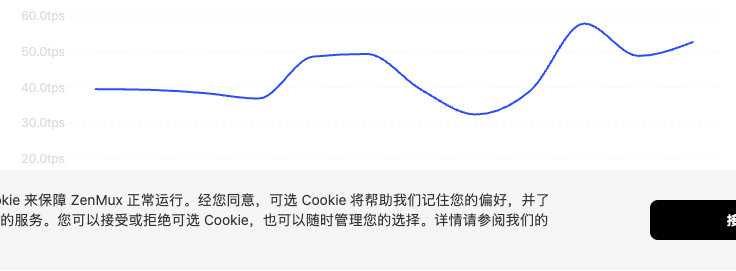
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
Oct 26, 18:00
Google Vertex52.7 tps
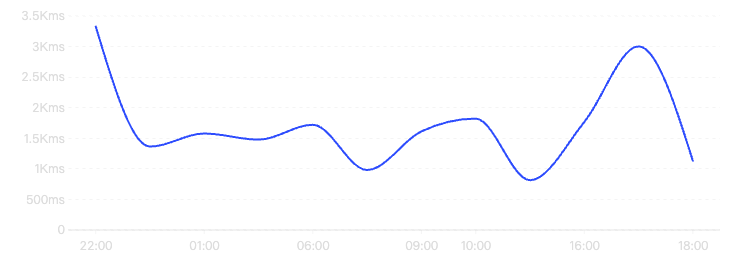
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
Oct 26, 18:00
Google Vertex1.13s
活动
该模型随时间变化的 token 用量和请求流量。
Token 消耗
Oct 25
Anthropic-
Google Vertex1.2M
Amazon Bedrock-
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
 Artificial Analysis


Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行


相关模型
更多模型来自 Anthropic