DeepSeek: DeepSeek V4 Flash 0731 是 DeepSeek V4 系列中面向效率的变体,作为预览版发布,并与旗舰版 V4-Pro 同时开源。它专为需要 V4 代次的长上下文和推理能力,但追求更快、更经济的 API 层的开发者而设计。与 V4-Pro 相比,DeepSeek: DeepSeek V4 Flash 0731 使用了更小的总参数和激活参数,这样实现更快的响应时间和更低的 API 成本。它保留了接近 V4-Pro 的推理能力,在简单的智能体任务上与 V4-Pro 持平,仅在要求最苛刻的智能体工作流中存在可察觉的差距。世界知识略低于 V4-Pro,但在开源领域内仍有竞争力。与 V4-Pro 一样,DeepSeek: DeepSeek V4 Flash 0731 继承了基于 Token 维度压缩和 DeepSeek 稀疏注意力 (DSA) 构建的新型注意力机制,标配支持 1M 上下文窗口,并提供带有 reasoning_effort 参数(high / max)的思考和非思考模式。迁移说明:旧版模型名称 deepseek-chat 和 deepseek-reasoner 目前分别路由到 DeepSeek: DeepSeek V4 Flash 0731 的非思考和思考模式,并将于 2026-07-24 退役。现有集成应迁移到明确的模型名称 deepseek-v4-flash 或 deepseek-v4-pro。该模型可通过 OpenAI ChatCompletions 和 Anthropic 接口访问,权重已在 Hugging Face 和 ModelScope 上开源。
返回模型列表 85.2%$0.22-0.44/ 百万 token$0.66-1.32/ 百万 token读取:0.007-0.014/ 百万 token写入:-/ 百万 token1M2.82s104tps
 -$0.22-0.44/ 百万 token$0.66-1.32/ 百万 token读取:0.014-0.028/ 百万 token写入:-/ 百万 token1M--
 91.0%$0.22-0.44/ 百万 token$0.66-1.32/ 百万 token读取:0.007-0.014/ 百万 token写入:-/ 百万 token1M1.85s114tps
 -$0.212-0.424/ 百万 token$0.636-1.272/ 百万 token读取:0.021-0.042/ 百万 token写入:-/ 百万 token1M--
 -$0.22-0.44/ 百万 token$0.66-1.32/ 百万 token读取:0.007-0.014/ 百万 token写入:-/ 百万 token1M--
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
Baidu
baidu
SiliconFlow
siliconflow
TencentCloud
tencent-cloud
Alibaba Cloud下线
alibaba
DeepSeek下线
deepseek
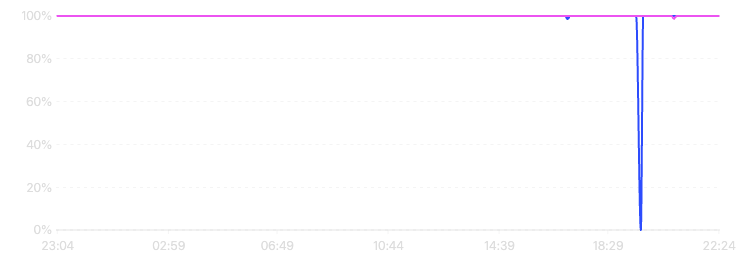
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 19:54
Baidu100.00%
TencentCloud100.00%
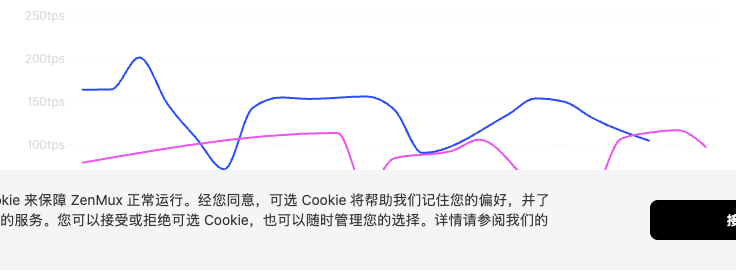
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
Oct 26, 19:00
Baidu104 tps
TencentCloud114 tps
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
活动
该模型随时间变化的 token 用量和请求流量。
Token 消耗
 Artificial Analysis
Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行


相关模型
更多模型来自 DeepSeek