
Qwen-Audio-3.1-ASR-Flash 是一款支持高效短语音识别的大规模模型,专为高质量、多语言及文化内容转写场景设计。该模型支持多语言及多地区方言识别,并针对中国古诗词的韵律、节奏及文言文表达优化了。它有上下文增强、标点预测及文本归一化功能。此版本还支持多方言的可控 ASR/AST 输出,并有原生转写与润色功能,以及工业级的多人对话角色转写能力。
返回模型列表 -$0.12/ 百万 token$0.41/ 百万 token读取:-/ 百万 token写入:-/ 百万 token1M--
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
Alibaba Cloud
alibaba
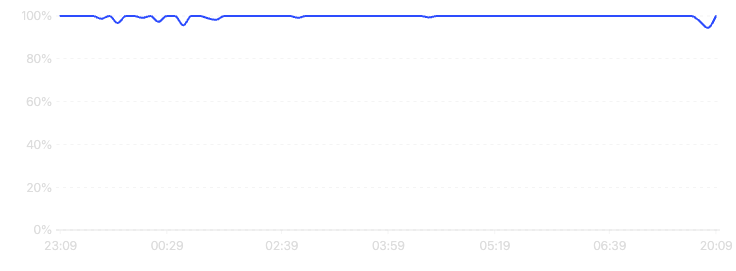
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 19:59
Alibaba Cloud97.65%
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
No data
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
No data
活动
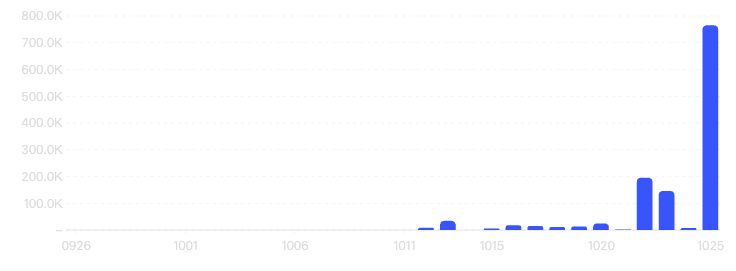
该模型随时间变化的 token 用量和请求流量。
Token 消耗
Oct 25
Alibaba Cloud765.0K
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
 Artificial Analysis
该模型暂无基准测试数据。
Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行

相关模型
更多模型来自 Qwen