MiniMax: MiniMax M3.1-Flash 是一款前沿的多模态语言模型,有 100 万 token 的上下文窗口,专为智能体推理、工具调用、编程和长文本任务而设计。它支持文本、图像和视频输入,并提供可调的思考深度(通过努力程度控制),以平衡推理质量、延迟和 token 使用量。
返回模型列表 98.8%$0.15/ 百万 token$0.6/ 百万 token读取:0.015/ 百万 token写入:-/ 百万 token1M4.3s89.4tps
供应商
在多个供应商之间路由请求。复制供应商标识以设置偏好供应商。
供应商缓存命中率上下文
MiniMax
minimax
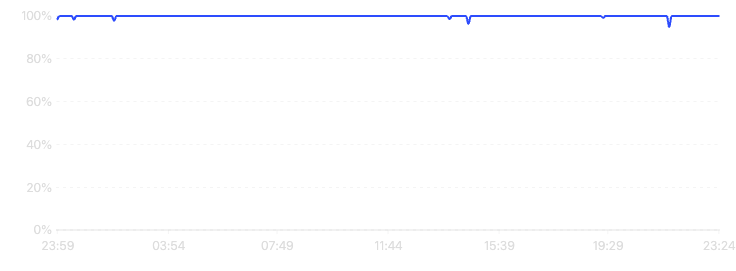
可用率
24 小时AI Gateway 直连请求及各供应商的成功率。
Oct 26, 19:59
MiniMax100.00%
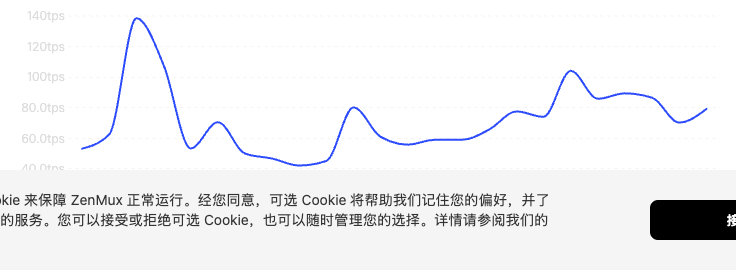
吞吐量
24 小时AI Gateway 实时流量的 P50 吞吐量,单位为每秒 token 数(TPS)。
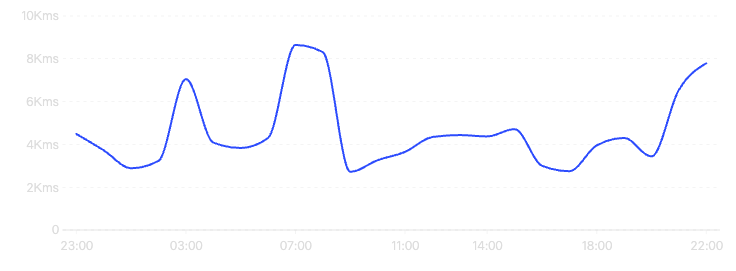
延迟
24 小时AI Gateway 实时流量的 P50 首 token 延迟(TTFT),单位为毫秒。
Oct 26, 19:00
MiniMax4.30s
活动
该模型随时间变化的 token 用量和请求流量。
Token 消耗
Oct 25
MiniMax2.4B
按实际处理请求的供应商拆分 token 用量。区块越大,表示该供应商处理的模型流量越多。
 Artificial Analysis
该模型暂无基准测试数据。
Apps
Public apps that send the most traffic to this model. Good signal for what real production workloads look like — and a hint at which use cases this model is best suited for. View All
Token 排行


相关模型
更多模型来自 MiniMax